
Veeltalige vertaling op skaal: 10000 taalpare en verder
Microsoft is op soek na AI op skaal met hoë ambisie om die volgende generasie AI-ervarings moontlik te maak. Die Microsoft-vertaler ZCode span werk saam met Microsoft-projek Turing en Microsoft Research Asia om taal- en meertalige ondersteuning in die kern van hierdie inisiatief te bevorder. Ons gaan voort om grense met veeltalige modelle te verskuif om verskeie taalscenario's regoor Microsoft te ondersteun. Verlede somer het ons ons grootskaalse aangekondig Veeltalige mengsel van kundige model met DeepSpeed wat beter kan presteer as individuele grootskaalse tweetalige modelle. Onlangs het die nuutste Turing universele taalvoorstellingsmodel (T-ULRv5), 'n Microsoft-geskepte model is weereens die nuutste en bo-aan die Google XTREME openbare puntelys in daardie tyd. Meer onlangs het Microsoft die grootste aangekondig Megatron-Turing NLG 530B parameters model.
Die jaarlikse Konferensie oor Masjienvertaling (ook bekend as WMT 2021) is verlede week in die pragtige Punta Cana, Dominikaanse Republiek, afgesluit. WMT bring navorsers van regoor die hele masjienvertalingsveld, beide die industrie en die akademie, bymekaar om deel te neem aan 'n reeks gedeelde take, wat elkeen 'n maatstaf definieer op 'n belangrike gebied van masjienvertaling om die veld na nuwe grense te stoot.
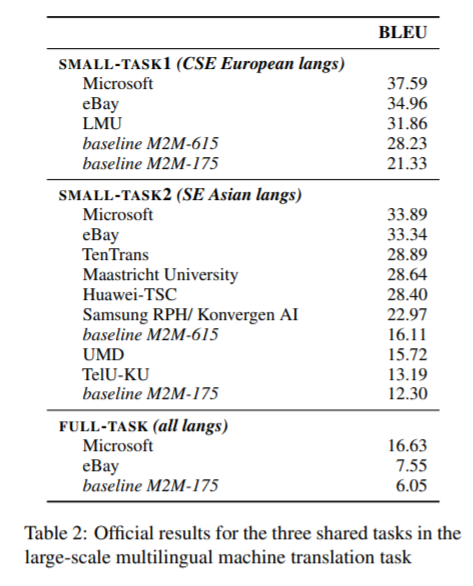
Die Microsoft Translator ZCode-span, wat saam met Turing-span en Microsoft Research Asia gewerk het, het meegeding in die "Grootskaalse Veeltalige Vertaling"-snit, wat bestaan het uit 'n volledige taak om tussen al 10 000 rigtings in 101 tale te vertaal, en twee Klein take: Een gefokus op 5 Sentraal- en Suid-Europese tale, en een op 5 Suidoos-Asiatiese tale. Die Microsoft ZCode-DeltaLM-model het al drie take met groot marges gewen, insluitend 'n ongelooflike 10+ puntwins bo die M2M100-model in die groot taak wat op 'n massiewe 10,000-taalpare geëvalueer is. (Bevindinge van die WMT 2021 Gedeelde taak oor grootskaalse veeltalige masjienvertaling, Wenzek et al, WMT 2021).
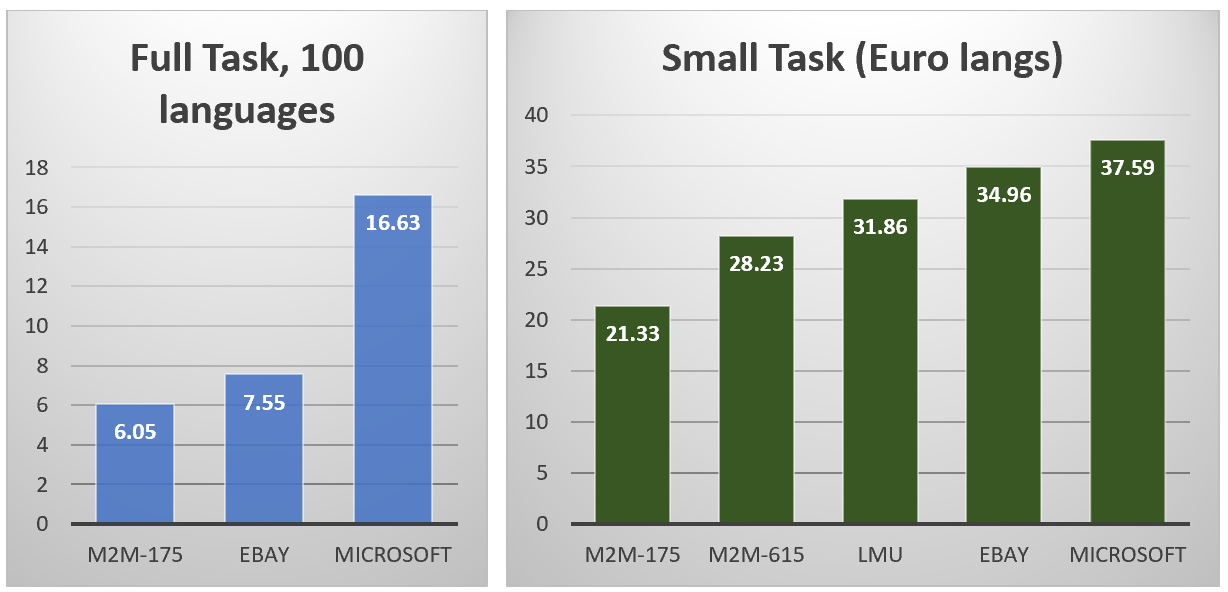
Figuur 1: Amptelike resultate (BLEU-tellings) oor die volledige taak en die klein taak1 by die WMT 2021 Grootskaalse veeltalige vertaling gedeelde taak
Die ZCode-DeltaLM-benadering
Kom ons kyk in hierdie blogpos onder die enjinkap na die wen Microsoft ZCode-DeltaLM-model. Ons beginpunt was DeltaLM (DeltaLM: Enkodeerder-dekodeerder Vooropleiding vir taalgenerering en -vertaling deur vooraf opgeleide meertalige enkodeerders aan te vul), die nuutste in die toenemend kragtige reeks massiewe meertalige vooropgeleide taalmodelle van Microsoft.
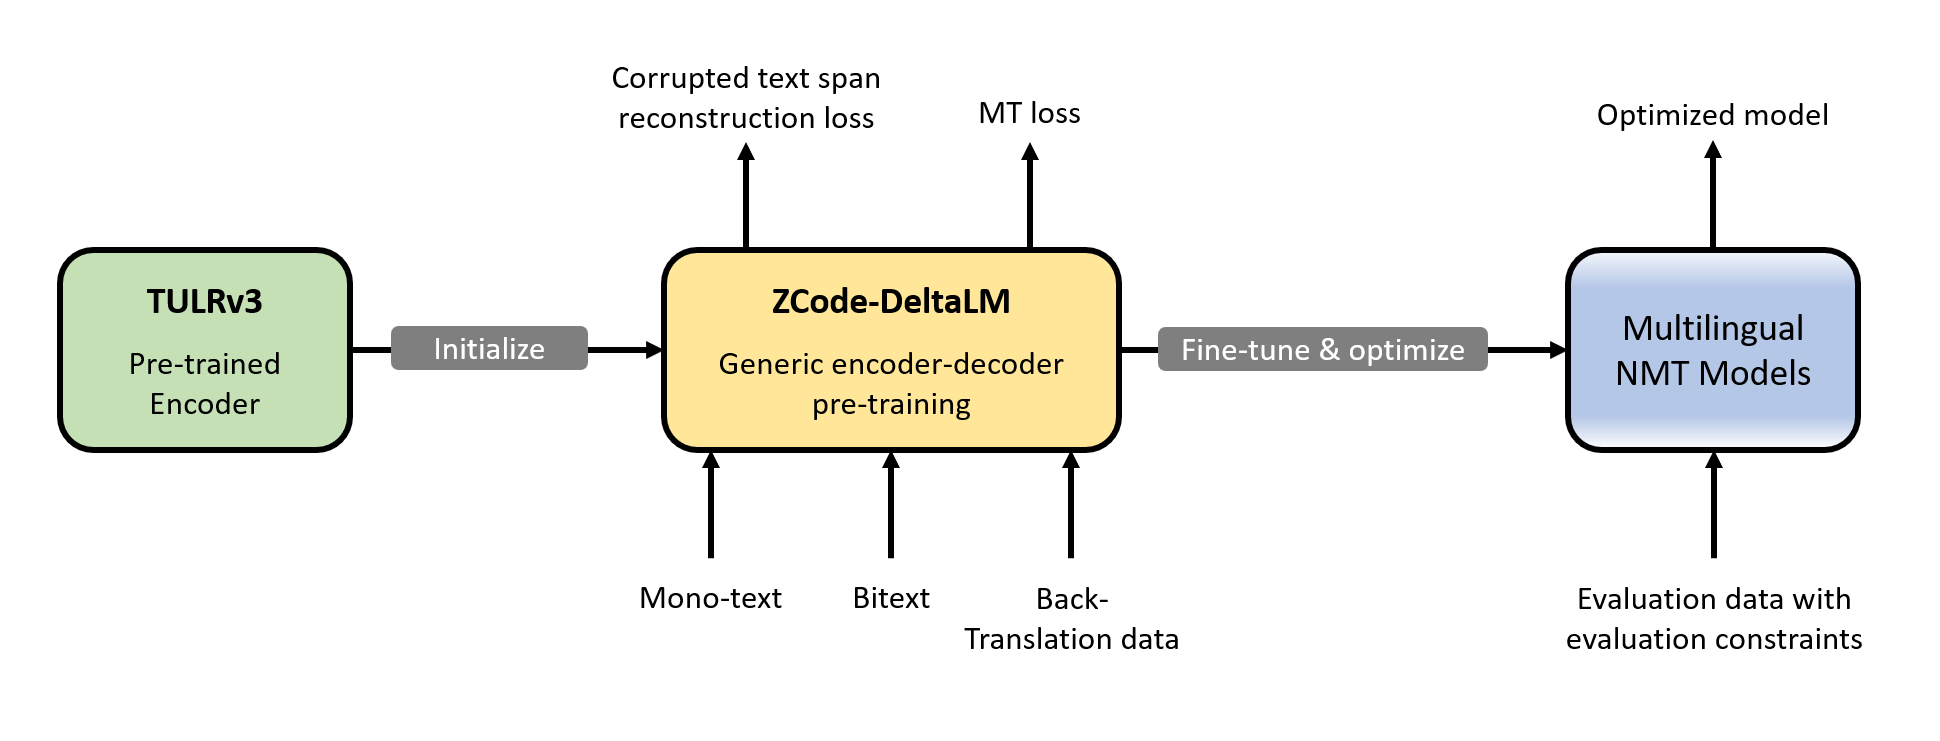
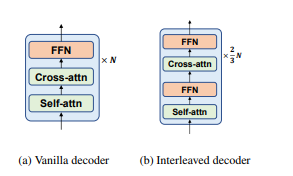
DeltaLM is 'n enkodeerder-dekodeerdermodel, maar in plaas daarvan om van nuuts af te oefen, word dit geïnisialiseer vanaf 'n voorheen vooraf opgeleide moderne enkodeerder-enigste model, spesifiek (TULRv3). Alhoewel die inisialisering van die enkodeerder eenvoudig is, is die dekodeerder minder, aangesien dit die self-aandag van die enkodeerder kruis. DeltaLM los hierdie probleem op met 'n nuwe verweefde argitektuur, waar die self-aandag en kruis-aandag wissel tussen lae, met die self-aandag wat gebruik word in die vreemde lae en kruis-aandag wat in die ewe lae gebruik word. Met hierdie interleaving pas die dekodeerderstruktuur by die enkodeerder, en dit kan dus ook op dieselfde manier vanaf TULRv3 geïnisialiseer word.
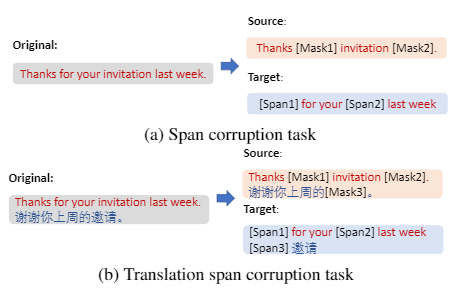
DeltaLM word aangevul deur ZCode kragtige multitask-leer: Multitaakleer vir veeltalige neurale masjienvertaling. Ons modelle toon dat die kombinasie van multitask en meertalige leer opleiding vir grootskaalse vooraf opgeleide taalmodelle aansienlik kan verbeter. Sodanige multitask meertalige leerparadigma maak gebruik van die induktiewe vooroordeel en regularisering van verskeie take en tale gelyktydig om beter te presteer op verskeie stroomaf take. Ons gebruik vertaaltaak, denoising auto encoder task en translation span corruption task soos aangetoon in die onderstaande figuur.
Wen die massief meertalige vertaalsnit
Om ons wen massiewe meertalige vertaalstelsel te bou (Veeltalige masjienvertalingstelsels van Microsoft vir WMT21 Gedeelde taak), het ons met zCode-DeltaLM begin en 'n paar truuks bygevoeg.
Ons pas progressiewe leer toe, oefen eers 'n model met 24 enkodeerderlae en 12 dekodeerderlae, en gaan dan voort met opleiding met 12 bygevoegde enkodeerderlae, wat 'n diep 36-laagkodeerder tot gevolg het. Om alle taalpare te dek, genereer ons dubbele pseudo-parallelle data waar beide kante van die parallelle data sinteties is, vertaal deur die model uit Engels. Ons pas ook iteratiewe terugvertaling toe om sintetiese data te genereer. Ons pas kurrikulumleer toe, begin met die hele lawaaierige opleidingsdata en verminder dit dan tot 'n skoon deelversameling. Ons weeg die vertaaldoelwit weer om parallelle data bo die terugvertaling en dubbel-pseudo-parallelle data te bevoordeel. Ons pas temperatuursteekproefneming toe om oor taalpare te balanseer. Vir elke taalpaar kies ons, gebaseer op die dev-stel, of ons direkte vertaling of draaivertaling deur Engels verkies.
Om dit alles saam te stel, het ons geweet ons het 'n ongelooflike massiewe veeltalige stelsel, maar die amptelike resultate op die blinde toetsstel het ons verwagtinge oortref. Ons het 2.5 tot 9 BLEU voor die volgende mededinger behaal, en 10 tot 21 BLEU-punte voor die basislyn M2M-175-model. Op die dev-toets het ons vergelyk met die groter M2M-615-model, wat ons ook met 10 tot 18 punte geklop het.
Beyond Translation: Universal Language Generation
Terwyl ons opgewonde is oor die groot oorwinning by WMT 2021, is dit nog meer opwindend dat ons ZCode-DeltaLM-model, anders as die ander mededingers, nie net 'n vertaalmodel is nie, maar eerder 'n algemene vooraf opgeleide enkodeerder-dekodeerder-taalmodel, bruikbaar vir allerhande generasietake buite vertaling. Dit stel ons modelle werklik in staat om redelik goed te presteer op verskeie meertalige natuurlike taalgenereringstake.
Ons het 'n nuwe SOTA bereik in baie gewilde generasie take van GEM Maatstaf, insluitend Wikilingua (opsomming), teksvereenvoudiging (WikiAuto) en struktuur-na-teks (WebNLG). Die DeltaLM-ZCode-model presteer baie groter modelle soos mT5 XL (3.7B), wat ook op baie groter data opgelei is. Dit het die doeltreffendheid en veelsydigheid van die modelle getoon wat gelei het tot sterk prestasie in baie take.
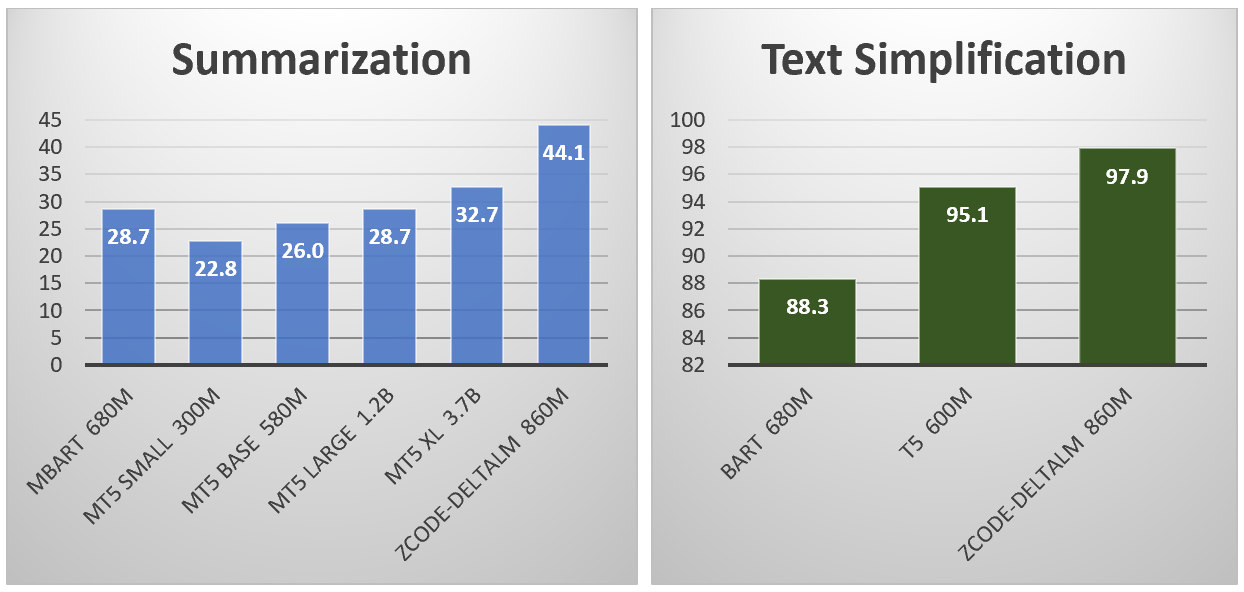
Figuur 2. Prestasie (RL-tellings) van ZCode-DeltaLM oor die opsommings- en teksvereenvoudigingstake in die GEM-maatstaf
Kyk vorentoe
Veeltalige masjienvertaling het 'n punt bereik waar dit baie goed presteer, wat tweetalige stelsels oorskry, in beide lae- en hoëhulpbrontale. Daar is getoon dat mengsel van kundiges (MoE) modelle baie goed pas om sulke modelle op te skaal soos in GShard getoon is. Ons ondersoek hoe om sulke modelle doeltreffend te skaal met Mengsel van kundiges: Skaalbare en doeltreffende MoE-opleiding vir veeltalige modelle met multitask. MoE-modelle met massiewe veeltalige data en onbewaakte multitask-opleiding bied ongekende geleentheid vir sulke modelle om werklik universele stelsels te bied wat die Microsoft Translator-span verder in staat kan stel om taalhindernisse regoor die wêreld uit te skakel, asook om 'n verskeidenheid natuurlike taalgenereringstake te ondersteun.
Erkennings
Ons wil graag erkenning gee aan en bedank Francisco Guzman en sy span wat die uiters veeltalige FLORES-toetsstel versamel het en hierdie WMT-baan met so 'n grootskaalse evaluering georganiseer het.


