
Tłumaczenie wielojęzyczne na dużą skalę: 10000 par językowych i więcej
Microsoft poszukuje AI na dużą skalę z wysokimi ambicjami, aby umożliwić następną generację doświadczeń AI. The Microsoft Translator Kod Z zespół współpracuje z Microsoft Project Turing oraz Microsoft Research Asia w celu rozwoju obsługi języków i wielojęzyczności u podstaw tej inicjatywy. Nadal przesuwamy granice dzięki modelom wielojęzycznym, aby obsługiwać różne scenariusze językowe w firmie Microsoft. Zeszłego lata ogłosiliśmy naszą dużą skalę Wielojęzyczna mieszanka ekspertów model z DeepSpeed które mogą przewyższać indywidualne modele dwujęzyczne na dużą skalę. Ostatnio najnowszy uniwersalny model reprezentacji języka Turinga (T-ULRv5), model stworzony przez Microsoft jest po raz kolejny najnowocześniejszy i na szczycie Google Publiczny ranking XTREME w tym czasie. Niedawno Microsoft ogłosił największy Megatron-Turing NLG 530B model parametrów.
Doroczna konferencja na temat tłumaczenia maszynowego (znana również jako WMT 2021) zakończyła się w zeszłym tygodniu w pięknej Punta Cana na Dominikanie. WMT skupia naukowców z całej dziedziny tłumaczenia maszynowego, zarówno z branży, jak i środowisk akademickich, aby uczestniczyć w serii wspólnych zadań, z których każde definiuje punkt odniesienia w ważnym obszarze tłumaczenia maszynowego, aby popchnąć tę dziedzinę na nowe granice.
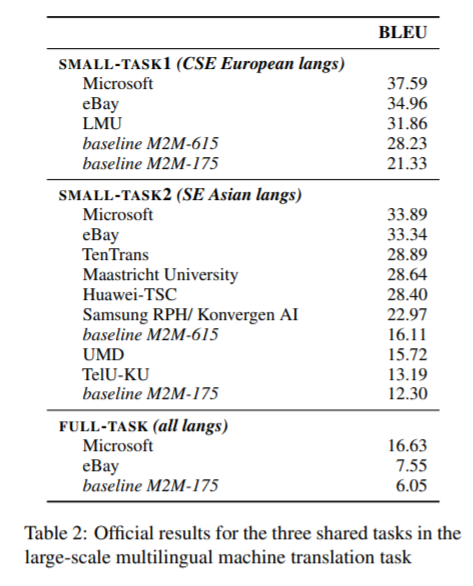
Zespół Microsoft Translator ZCode, współpracujący z zespołem Turing i Microsoft Research Asia, rywalizował w ścieżce "Large-scale Multilingual Translation", która składała się z pełnego zadania tłumaczenia między wszystkimi 10 000 kierunkami w 101 językach oraz dwóch małych zadań: jedno koncentrowało się na 5 językach europy środkowej i południowej, a drugie na 5 językach Azji Południowo-Wschodniej. Model Microsoft ZCode-DeltaLM wygrał wszystkie trzy zadania z ogromnym marginesem, w tym niesamowity wzrost o ponad 10 punktów w stosunku do modelu M2M100 w dużym zadaniu ocenianym na ogromnej liczbie par językowych 10 000. (Ustalenia wspólnego zadania WMT 2021 dotyczącego wielojęzycznego tłumaczenia maszynowego na dużą skalę, Wenzek i in., WMT 2021).
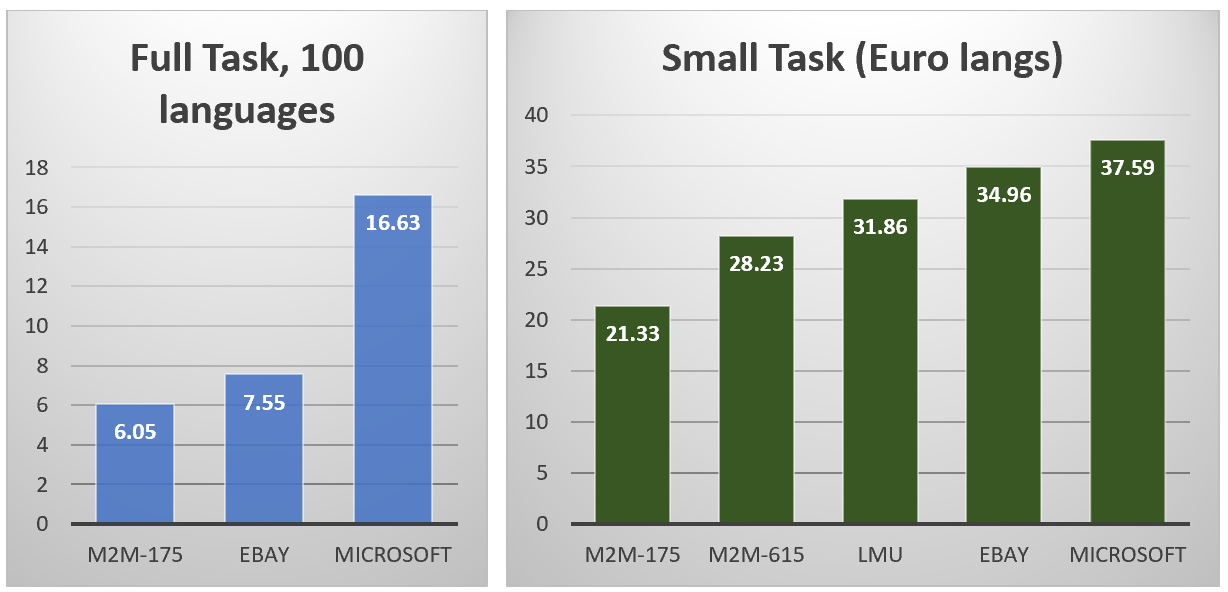
Rysunek 1: Oficjalne wyniki (wyniki BLEU) dotyczące pełnego i małego zadania1 w zadaniu współdzielonym WMT 2021 Large Scale Multilingual Translation
Podejście ZCode-DeltaLM
W tym poście na blogu rzućmy okiem pod maskę na zwycięski model Microsoft ZCode-DeltaLM. Naszym punktem wyjścia był DeltaLM (DeltaLM: Wstępne szkolenie kodera-dekodera do generowania i tłumaczenia języka poprzez rozszerzanie wstępnie wyszkolonych wielojęzycznych koderów), najnowszy z coraz potężniejszej serii masowo wielojęzycznych wstępnie wyszkolonych modeli językowych firmy Microsoft.
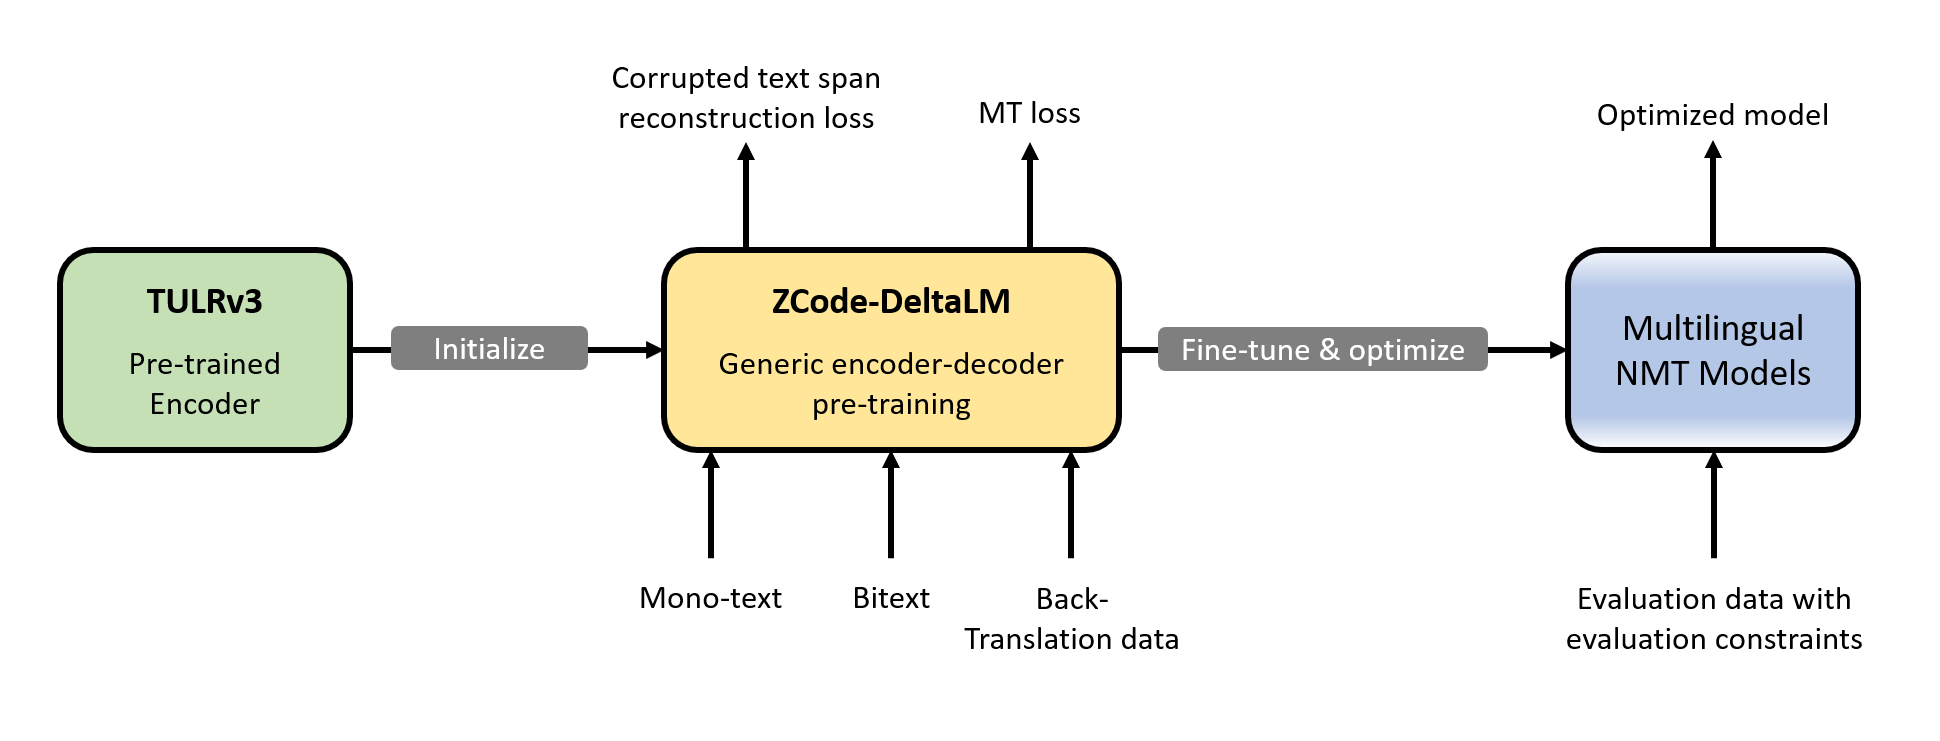
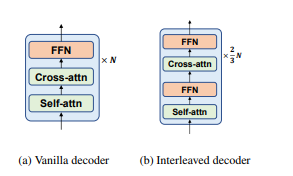
DeltaLM jest modelem kodera-dekodera, ale zamiast trenować od zera, jest inicjowany z wcześniej wstępnie wyszkolonego, najnowocześniejszego modelu tylko enkodera, w szczególności (TULRv3). Podczas gdy inicjowanie kodera jest proste, dekoder jest mniej prosty, ponieważ dodaje uwagę krzyżową do samouwagi kodera. DeltaLM rozwiązuje ten problem za pomocą nowatorskiej architektury przeplatanej, w której samouwrót uwagi i uwaga krzyżowa zmieniają się między warstwami, z samoodwrótką używaną w warstwach nieparzystych i uwagą krzyżową używaną w warstwach parzystych. Dzięki temu przeplataniu struktura dekodera pasuje do enkodera, dzięki czemu można ją również zainicjować w ten sam sposób z TULRv3.
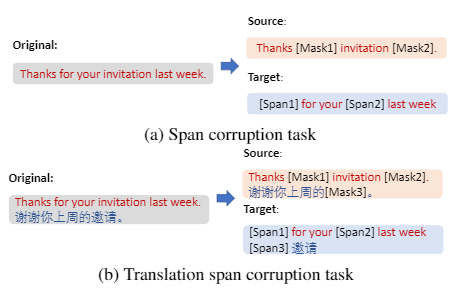
DeltaLM jest rozszerzony przez potężne wielozadaniowe uczenie się ZCode: Wielozadaniowe uczenie się dla wielojęzycznego neuronowego tłumaczenia maszynowego. Nasze modele pokazują, że połączenie wielozadaniowości i wielojęzycznego uczenia się może znacznie poprawić szkolenie w zakresie wstępnie wyszkolonych modeli językowych na dużą skalę. Taki wielozadaniowy wielojęzyczny paradygmat uczenia się wykorzystuje indukcyjne odchylenie i regularyzację z kilku zadań i języków jednocześnie, aby lepiej wykonywać różne zadania podrzędne. Używamy zadania tłumaczenia, zadania odszumiania automatycznego kodera i zadania uszkodzenia zakresu tłumaczenia, jak pokazano na poniższym rysunku.
Wygrana w masowo wielojęzycznej ścieżce tłumaczeniowej
Aby zbudować nasz zwycięski masowo wielojęzyczny system tłumaczeń (Wielojęzyczne systemy tłumaczenia maszynowego firmy Microsoft dla współdzielonego zadania WMT21), zaczęliśmy od zCode-DeltaLM i dodaliśmy kilka sztuczek.
Stosujemy uczenie progresywne, najpierw trenując model z 24 warstwami enkodera i 12 warstwami dekodera, a następnie kontynuujemy szkolenie z 12 dodanymi warstwami enkodera, w wyniku czego powstaje głęboki 36-warstwowy koder. Aby objąć wszystkie pary językowe, generujemy podwójne pseudorównoległe dane, w których obie strony danych równoległych są syntetyczne, przetłumaczone przez model z języka angielskiego. Stosujemy również iteracyjną translację wsteczną do generowania danych syntetycznych. Stosujemy naukę programową, zaczynając od całych hałaśliwych danych treningowych, a następnie redukując je do czystego podzbioru. Ponownie ważymy cel tłumaczenia, aby faworyzować dane równoległe nad danymi z translacji wstecznej i podwójnymi pseudorównoległymi danymi. Stosujemy próbkowanie temperatury, aby zrównoważyć pary językowe. Dla każdej pary językowej wybieramy, w oparciu o zestaw deweloperów, czy preferujemy tłumaczenie bezpośrednie, czy tłumaczenie przestawne na język angielski.
Składając to wszystko razem, wiedzieliśmy, że mamy niesamowity, masowo wielojęzyczny system, ale oficjalne wyniki w ślepym zestawie testowym przekroczyły nasze oczekiwania. Zdobyliśmy od 2,5 do 9 BLEU przed kolejnym konkurentem i od 10 do 21 punktów BLEU przed podstawowym modelem M2M-175. W teście deweloperskim porównaliśmy z większym modelem M2M-615, który również pokonaliśmy o 10 do 18 punktów.
Beyond Translation: Universal Language Generation
Chociaż jesteśmy podekscytowani wielką wygraną na WMT 2021, jeszcze bardziej ekscytujące jest to, że w przeciwieństwie do innych konkurentów, nasz model ZCode-DeltaLM nie jest tylko modelem tłumaczenia, ale raczej ogólnym wstępnie wyszkolonym modelem języka kodera-dekodera, nadającym się do wszelkiego rodzaju zadań generowania poza tłumaczeniem. To naprawdę pozwala naszym modelom całkiem dobrze wykonywać różne wielojęzyczne zadania generowania języka naturalnego.
Osiągnęliśmy nową SOTA w wielu popularnych zadaniach generacji od GEM Benchmark, w tym Wikilingua (podsumowanie), uproszczenie tekstu (WikiAuto) i struktura do tekstu (WebNLG). Model DeltaLM-ZCode znacznie przewyższa znacznie większe modele, takie jak mT5 XL (3.7B), który jest również szkolony na znacznie większych danych. Pokazało to wydajność i wszechstronność modeli, co doprowadziło do wysokiej wydajności w wielu zadaniach.
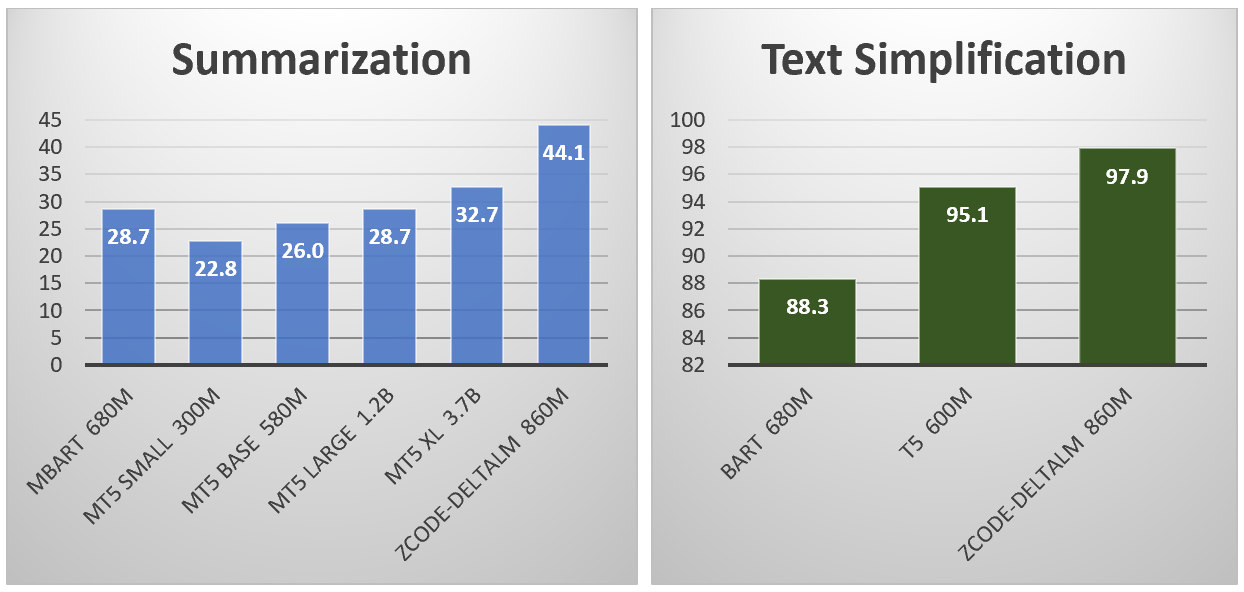
Ryc. 2. Wydajność (wyniki RL) ZCode-DeltaLM w zadaniach Podsumowanie i Uproszczenie tekstu w benchmarku GEM
Patrząc w przyszłość
Wielojęzyczne tłumaczenie maszynowe osiągnęło punkt, w którym działa bardzo dobrze, przewyższając systemy dwujęzyczne, zarówno w językach o niskich, jak i wysokich zasobach. Wykazano, że modele Mix of Experts (MoE) bardzo dobrze pasują do skalowania takich modeli, jak pokazano w GShard. Badamy, jak skutecznie skalować takie modele za pomocą Mix of Experts: Skalowalne i wydajne szkolenia MoE dla wielojęzycznych modeli wielozadaniowych. Modele MoE z ogromnymi wielojęzycznymi danymi i nienadzorowanym szkoleniem wielozadaniowym stanowią dla takich modeli nieprecedentną szansę na zapewnienie prawdziwie uniwersalnych systemów, które mogą dodatkowo umożliwić zespołowi Microsoft Translator wyeliminowanie barier językowych na całym świecie, a także obsługę różnych zadań generowania języka naturalnego.
Potwierdzenia
Chcielibyśmy podziękować i podziękować Francisco Guzmanowi i jego zespołowi, którzy zebrali masowo wielojęzyczny zestaw testowy FLORES i zorganizowali ten tor WMT z tak dużą oceną.


