
Microsoft Translator stel literêre Chinese vertaling vry
By die lees Antieke Chinese poësie, ons verwonder ons dikwels aan die wonderlike woorde wat antieke skrywers kon gebruik om mense, gebeure, voorwerpe en tonele te beskryf. Dit is 'n wonderlike kultuurskat wat vir ons agtergelaat is. Soortgelyk aan Shakespeare'se verse in die Engelse taal, die literêre Chinees wat deur hierdie digters gebruik word, is dikwels moeilik vir hedendaagse mense om te verstaan, en die betekenisse en subtiliteite wat daarin ingebed is, gaan gereeld verlore.
Om hierdie probleem op te los, het navorsers by Microsoft Research Asia die nuutste neurale masjienvertalingstegnieke gebruik om direkte vertaalmodelle tussen literêre Chinees en moderne Chinees op te lei, wat ook lei tot die skep van vertaalvermoëns tussen literêre Chinees en meer as 90 ander tale en dialekte in Microsoft Translator. Tans is literêre Chinese vertaling geïntegreer in die Microsoft Translator app, Azure Cognitive Services Translator, en 'n aantal Microsoft-produkte wat deur Microsoft Translator-dienste ondersteun word.
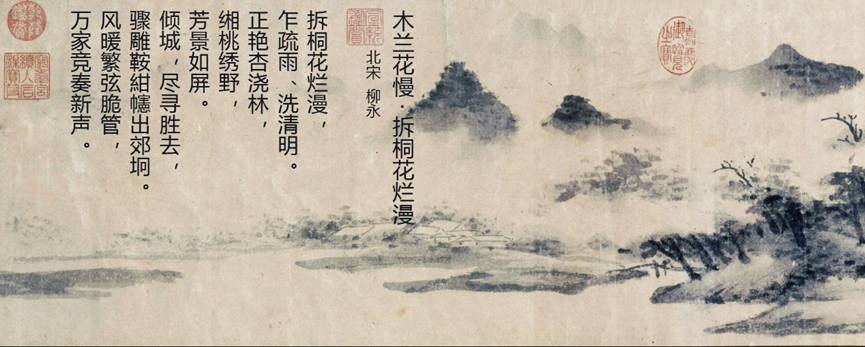
Beeld: Die skildery uit "West Mountain in Misty Rain" deur Shen Zhou, Ming-dinastie. Die antieke Chinese gedig oor die skildery kom uit Yong Liu, Noordelike Song -dinastie. Die gedig beeld die lentelandskap in die suide van China uit tydens die Qingming-fees en die welvaart van die sosiale lewe.
Om meer mense in staat te stel om die sjarme van die tradisionele Chinese kultuur te waardeer
Literêre Chinees is 'n belangrike draer van die tradisionele Chinese kultuur. Omvangryke boeke en tekste uit die antieke tyd het China opgeteken'se ryk en diepgaande kultuur oor die afgelope vyfduisend jaar. Die gedagtes en wysheid wat daarin opgehoop en vervat is, is waardig om voortdurend te verken en te dink.
Met behulp van masjienvertaling kan toeriste nou antieke Chinese tekste en gedigte verstaan wat op historiese geboue en monumente geskryf is, studente het nou 'n ekstra hulpmiddel om hulle te help om Chinees te leer, en navorsers wat besig is met die versameling en vertaling van antieke tekste kan meer produktief wees.
Dongdong Zhang, 'n hoofnavorser by Microsoft Research Asia, het gesê: "Vanuit 'n tegniese perspektief kan literêre Chinees as 'n aparte taal beskou word. Sodra vertaling tussen literêre Chinees en moderne Chinees realiseer, word die vertaling tussen literêr Chinees en ander tale soos Engels, Frans en Duits natuurlik 'n vanselfsprekendheid."
Grootste probleem met literêre Chinese vertaling AI-model: Min opleidingsdata
Die mees kritieke element van AI-modelopleiding is data. Slegs as die datavolume groot genoeg is en die kwaliteit daarvan hoog genoeg is Kan Jy lei 'n meer akkurate model op. In masjienvertaling vereis die opleiding van die model tweetalige data: oorspronklike teksdata en teikentaaldata. Die vertaling van literêre Chinees is baie spesiaal, soos dit's nie 'n taal wat in die daaglikse lewe gebruik word nie. Daarom, in vergelyking met die vertaling van ander tale, is die opleidingsdata van literêre Chinese vertaling baie klein, wat nie bevorderlik is vir die opleiding van masjienvertalingsmodelle nie.
Alhoewel navorsers van Microsoft Research Asia in die vroeë stadiums baie publiek beskikbare literêre en moderne Chinese data versamel het, kan die oorspronklike data nie direk gebruik word nie. Data skoonmaak moet uitgevoer word om data uit verskillende bronne, verskillende formate, sowel as volle breedte / te normaliseer.Leestekens met 'n halwe breedte, as 'n manier om die inmenging van ongeldige data oor modelopleiding te verminder. Op hierdie manier word die werklike beskikbare data van hoë gehalte verder verminder.
Volgens Shuming Ma, 'n navorser by Microsoft Research Asia, het navorsers 'n groot hoeveelheid datasintese en aanvullingswerk gedoen om die kwessie van ylheid van data te verminder, insluitend:
Eerstens, algemene karakter– gebaseerde belyning en uitbreiding om die grootte van opleidingsdata te verhoog. Anders as vertalings tussen Chinees en ander tale soos Engels, Frans, Russies, ens., Literêre Chinees en moderne Chinees gebruik dieselfde karakterstel. Deur voordeel te trek uit hierdie funksie, het navorsers by Microsoft Research Asia innoverende algoritmes gebruik om masjienvertaling toe te laat om algemene karakters te herroep, natuurlike belyning uit te voer en dan verder uit te brei na woorde, frases en kort sinne, en sodoende 'n groot hoeveelheid bruikbare data te sintetiseer.
Tweedens, vervorm sinstruktuur om die robuustheid van masjienvertaling te verbeter. Met betrekking tot onderbrekings in tekste en gedigte, het navorsers 'n aantal variante bygevoeg om masjiene meer omvattend te maak in die aanleer van antieke gedigte. Vir mense, selfs wanneer hulle 'n sin sien wat abnormaal gestruktureer is, soos 'n gedig wat in reëls gesegmenteer is op grond van ritme eerder as volsinne, kan hulle steeds die dele bymekaar sit en verstaan. Maar vir 'n vertaalmodel wat nog nooit so 'n segmentering gesien het nie, sal dit waarskynlik verwar word. Daarom kan transformasie van dataformaat nie net die hoeveelheid opleidingsdata uitbrei nie, maar ook die robuustheid van die opleiding van die vertaalmodel verbeter.
Derdens, doen tradisionele en vereenvoudigde karaktervertalingsopleiding om modelaanpasbaarheid te verhoog. In Chinees bestaan tradisionele karakters in beide literêre en moderne Chinese. Toe navorsers die model opgelei het om die aanpasbaarheid van die model te verbeter, het hulle nie net data in vereenvoudigde Chinees gebruik nie, maar ook data in tradisionele Chinees bygevoeg, asook data gemeng met tradisionele en vereenvoudigde karakters. Die model kan dus beide die tradisionele en vereenvoudigde inhoud verstaan, wat lei tot meer akkurate vertaalresultate.
Vierdens, verhoog die opleiding van vreemde taalwoorde om die akkuraatheid van vertaling te verbeter. Wanneer moderne Chinees in literêre Chinees vertaal word, is daar dikwels moderne woorde wat afgelei is van vreemde taalwoorde en nuwe woorde wat nog nooit in antieke Chinees verskyn het nie, soos "Microsoft", "rekenaar", "hoëspoedspoor", en baie ander hou daarvan. Om hierdie probleem te hanteer, het navorsers 'n klein model opgelei om entiteite te herken. Die model vertaal eers die betekenis van die woord buite die entiteit en vul dan die entiteit weer in om die akkuraatheid van die masjien te verseker'se verwerking van die vreemde woorde.
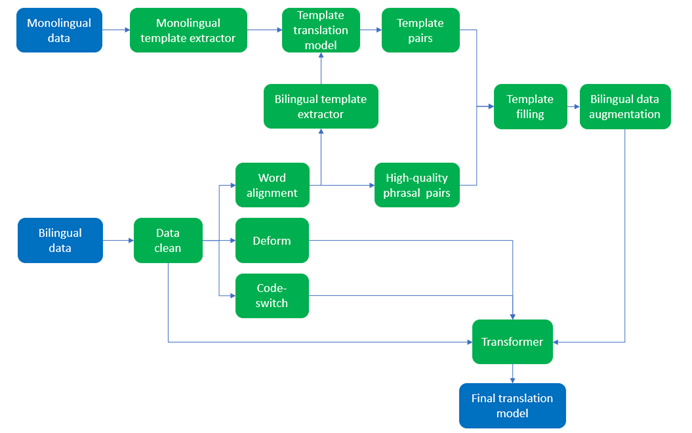
Beeld: THy literêre Sjinees Vertaalproses
Daarbenewens is die masjienvertalingsmodel vir informele skryfstyle soos blogs, forums, Weibo, ensovoorts spesifiek opgelei om die robuustheid van vertaling tussen moderne en literêre Chinees verder te verbeter.
Dongdong Zhang het gesê: "Op grond van die huidige vertaalstelsel sal ons voortgaan om die datastel te verryk en die modelopleidingsmetode te verbeter om dit meer robuust en veelsydig te maak. In die toekoms kan die metode nie net vir literêre Chinese vertaling gebruik word nie, maar kan dit ook na ander toepassingscenario's uitgebrei word."


