
Преводачът на Microsoft издава литературен китайски превод
При четене древен Китайски поезия, често се удивляваме на много прекрасните думи, които древните писатели биха могли да използват, за да опишат хората, събитията, предметите и сцените. Това е върхът културно съкровище, което е оставено за нас. Въпреки това, подобно на Шекспир's стихове на английски език, литературните китайци, използвани от тези поети, често е трудно за съвременните хора да разберат, а значения и тънкости, вградени в него, често се губят.
За да решат този проблем, изследователи в Microsoft Research Asia приеха най-новите техники за превод на невронни машини за обучение на модели за директен превод между литературни китайски и съвременни китайски, което също води до създаване на възможности за превод между литературни китайски и повече от 90 други езика и диалекти в Преводач на Microsoft. Понастоящем литературният китайски превод е интегриран в Microsoft translator приложение, Преводач на когнитивни услуги в Azure, и редица продукти на Microsoft, които се поддържат от услугите на Microsoft Translator.
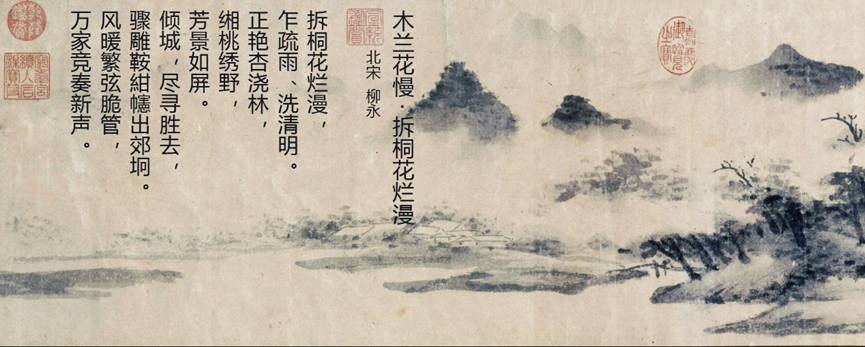
Изображение: Картината от "Западна планина в мисти дъжд" от Шен Жоу, Династия Минг. Древното китайско стихотворение на картината е от Йонг Лиу, Северна сонг династия. Поемата изобразява пролетната природа в Южен Китай по време на фестивала Цинминг и просперитета на социалния живот.
Даване на възможност на повече хора да оценят очарованието на традиционната китайска култура
Литературен китайски е важен носител на традиционната китайска култура. Обемни книги и текстове от древните времена са записали Китай'богатата и дълбока култура през последните пет хиляди години. Мислите и мъдростта, натрупани и съдържащи се в тях, са достойни за непрекъснато изследване и мислене.
С помощта на машинен превод туристите вече могат да разберат древни китайски текстове и стихове, написани на исторически сгради и паметници, студентите вече имат допълнителен инструмент, който да им помогне да научат китайски, а изследователите, които се занимават с колатриране и превод на древни текстове, могат да бъдат по-продуктивни.
Донгдонг Джан, главен изследовател в Microsoft Research Asia, заяви: "От техническа гледна точка литературният китайски може да се разглежда като отделен език. След като се реализира превод между литературен китайски и съвременен китайски, преводът между литературни китайски и други езици като английски, френски и немски става въпрос разбира се."
Най-голяма трудност на литературен китайски превод AI модел: Малко данни за обучение
Най-критичният елемент от обучението по AI модел са данните. Само когато обемът на данните е достатъчно голям и качеството му е достатъчно високо Cna ти обучават по-точен модел. При машинен превод обучението на модела изисква двуезични данни: оригинални текстови данни и данни за целевия език. Преводът на литературен китайски е много специален, тъй като"s не е език, използван в ежедневието. Следователно, в сравнение с превода на други езици, данните от обучението на литературен китайски превод са много малки, което не е благоприятстващо обучението на моделите за машинен превод.
Въпреки че изследователите на Microsoft Research Asia събраха много публично достъпни литературни и съвременни китайски данни в ранните етапи, оригиналните данни не могат да бъдат пряко използвани. Почистването на данни трябва да се проведе, за да се нормализират данните от различни източници, различни формати, както и с пълна ширина/пунктуации с половин ширина, като средство за свеждане до минимум на смущенията на невалидните данни за моделно обучение. По този начин действителните налични висококачествени данни се намаляват допълнително.
Според Shuming Ma, изследовател в Microsoft Research Asia, с цел намаляване на проблема с раздвояването на данните, изследователите са провели голямо количество синтез на данни и аугментационна работа, включително:
Първо, общ знак– основано подравняване и разширяване, за да се увеличи размерът на данните за обучението. Различни от преводи между китайски и други езици като английски, френски, руски и т.н., литературни китайски и съвременни китайци използват един и същ набор знаци. Възползвайки се от тази функция, изследователите в Microsoft Research Asia са използвали иновативни алгоритми, за да позволят на машинния превод да припомни общи знаци, да проведе естествено подравняване и след това допълнително да се разшири до думи, фрази и кратки изречения, като по този начин синтезира голямо количество използваеми данни.
Второ, деформиране на структурата на изречението за подобряване на здравината на машинния превод. Относно почивки в текстове и стихове, изследователите са добавили редица варианти, за да направят машините по-всеобхватни в изучаването на древни стихове. За хората, дори когато видят изречение, което е структурирано необичайно, като стихотворение, сегментиращо се в линии, базирани на ритъм, а не на пълни изречения, те все още могат да съберат частите и да го разберат. Но за модел на превод, който никога преди не е виждал такава сегментация, най-вероятно ще бъде объркан. Ето защо, трансформацията на формат на данните може не само да разшири размера на данните от обучението, но и да подобри здравината на обучението по модел на превод.
Трето, провеждайте традиционно и опростено обучение за превод на знаци, за да увеличите приспособимостта на модела. На китайски, традиционните герои съществуват както в литературни, така и в съвременни китайски. Когато изследователите са обучили модела, за да подобрят приспособимостта на модела, те не само са ливъридж данни на опростен китайски, но и са добавили данни на традиционен китайски, както и данни, смесени с традиционни и опростени знаци. По този начин моделът може да разбере както традиционното, така и опростеното съдържание, което води до по-точни резултати от превода.
Четвърто, увеличете обучението на чуждите езикови думи за подобряване на точността на превода. При превода на съвременния китайски на литературен китайски, често има съвременни думи, получени от чуждоезиково думи и нови думи, които никога не са се появявали на древен китайски, като "Microsoft", "компютър", "високоскоростна релса" и много други го харесват. За да се справят с този проблем, изследователите обучиха малък модел за разпознаване на обекти. Моделът първо преведе значението на думата извън обекта, след което запълни обекта обратно, за да гарантира точността на машината's обработка на чуждите думи.
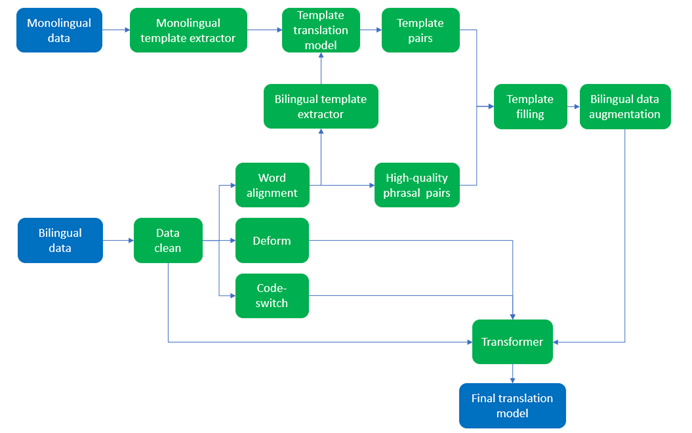
Изображение: ТТой литературен китайски процес на превод
В допълнение, за неформални стилове на писане като блогове, форуми, Weibo, и така нататък, моделът за машинен превод е обучен специално за по-нататъшно подобряване на здравината на превода между съвременния и литературния китайски.
Dongdong Zhang изрази: "Въз основа на настоящата система за превод ще продължим да обогатяваме набора от данни и да подобряваме метода на обучение на модела, за да го направим по-здрав и универсален. В бъдеще методът може не само да се използва за литературен китайски превод, но може да бъде разширен и до други сценарии за приложение."


