
微软翻译器发布文学中文翻译
阅读时 古代 中文 在诗歌中,我们常常惊叹于古代作家可以用非常美妙的词语来描述人、事件、物体和场景。这是为我们留下的灿烂的文化财富。然而,与莎士比亚类似’由于这些诗人使用的英文诗句对现代人来说往往难以理解,而且其中蕴含的意义和微妙之处经常被遗失。
为了解决这个问题,微软亚洲研究院的研究人员采用了最新的神经机器翻译技术来训练文学中文和现代中文之间的直接翻译模型,这也使得文学中文和现代中文之间产生了翻译能力。 90多种其他语言 和方言在微软翻译机中的应用。目前,文学类中文翻译已被纳入 Microsoft Translator 应用, Azure认知服务翻译器,以及一些由微软翻译服务支持的微软产品。
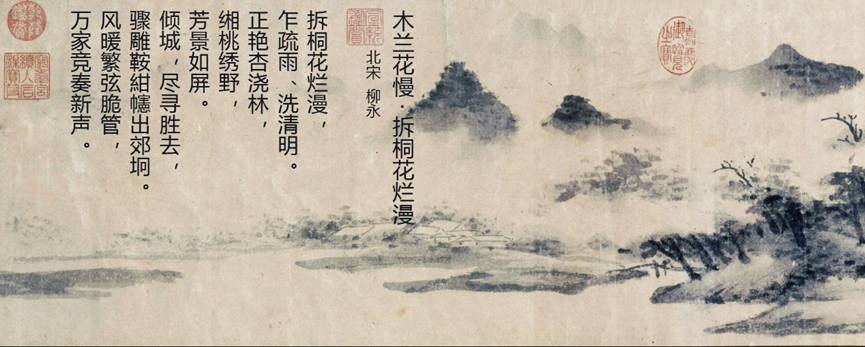
图片。明朝沈周的《雨中西山》画作。画上的中国古诗词来自于 勇 刘墉,北宋人。这首诗描绘了中国南方在清明节期间的春景和社会生活的繁荣景象。
让更多人领略中国传统文化的魅力
文学汉语是中国传统文化的重要载体。自古以来,大量的书籍和文本记录了中国的历史。’在过去的五千年里,中国丰富而深刻的文化。其中所积累和蕴含的思想和智慧,值得我们不断探索和思考。
在机器翻译的帮助下,游客现在可以理解写在历史建筑和纪念碑上的中国古文和诗歌,学生现在有了一个额外的工具来帮助他们学习中文,而从事整理和翻译古文的研究人员可以有更多的收获。
微软亚洲研究院的首席研究员张冬冬说:"从技术角度来看,文言文可以被看作是一种独立的语言。一旦实现了文学性汉语和现代汉语之间的翻译,文学性汉语和其他语言如英语、法语和德语之间的翻译就变得理所当然了。"
文学中文翻译AI模型的最大困难。训练数据少
人工智能模型训练的最关键因素是数据。只有当数据量足够大,质量足够高的时候 可以 你 训练一个更准确的模型。在机器翻译中,模型的训练需要双语数据:原始文本数据和目标语言数据。文学类中文的翻译非常特殊, 因为它不是一种日常生活中使用的语言。 因此,与其他语言的翻译相比,文学类中文翻译的训练数据非常少,这不利于机器翻译模型的训练。
虽然微软亚洲研究院的研究人员在前期收集了大量公开的文学和现代汉语数据,但原始数据不能直接使用。需要进行数据清洗,将来自不同来源、不同格式的数据以及全幅/半幅的数据规范化。半宽标点符号, 作为一种手段,尽量减少无效数据对模型训练的干扰。这样一来,实际可用的高质量数据就会进一步减少。
据微软亚洲研究院的研究员马树明介绍,为了减少数据稀少的问题,研究人员进行了大量的数据合成和扩充工作,包括。
第一,共同特征– 基于对齐和扩展来增加训练数据量。 不同于 在中文和其他语言如英语、法语、俄语等的翻译中,文言文和现代汉语使用相同的字符集。利用这一特点,微软亚洲研究院的研究人员利用创新算法,让机器翻译回忆起常见的字符,进行自然对齐,然后进一步扩展到单词、短语和短句,从而合成大量的可用数据。
第二,对句子结构进行变形,以提高机器翻译的稳健性。 关于 文本和诗词中的断句,研究人员增加了一些变体,使机器在学习古诗词时更加全面。对于人们来说,即使看到一个结构异常的句子,比如一首诗根据节奏被分割成几行,而不是完整的句子,他们仍然可以把各部分放在一起并理解它。但对于一个从未见过这种分段的翻译模型来说,它很可能会感到困惑。因此,数据格式的转换不仅可以扩大训练数据的数量,还可以提高翻译模型训练的鲁棒性。
第三,进行传统和简化的字符翻译训练,以提高模型的适应性。 在中文中,文言文和现代汉语中都存在繁体字。当研究人员对模型进行训练时,为了提高模型的适应性,他们不仅利用了简体中文的数据,还增加了繁体中文的数据,以及混有繁体字和简体中文的数据。因此,该模型可以同时理解繁体和简体内容,从而获得更准确的翻译结果。
第四,增加外语单词的训练,提高翻译的准确性。 在将现代汉语翻译成文言文时,经常会出现由外语词汇衍生出来的现代词和古汉语中从未出现过的新词,如 "微软"、"电脑"、"高铁",以及许多类似的词。为了处理这个问题,研究人员训练了一个小型模型来识别实体。该模型首先翻译了实体外的词义,然后再把实体填进去,以确保机器的准确性’的外国话的处理。
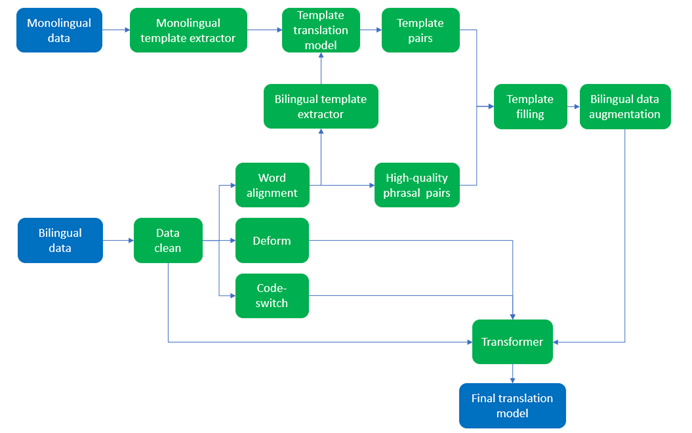
图片。T他 文学中文 翻译过程
此外,对于博客、论坛、微博等非正式的写作方式,机器翻译模型也进行了专门训练,以进一步提高现代汉语和文言文之间的翻译稳健性。
张冬冬表示,"在目前的翻译系统基础上,我们将继续丰富数据集,改进模型训练方法,使其更加强大和通用。未来,该方法可能不仅用于文学中文翻译,还可以扩展到其他应用场景"。


