
Neurale masjienvertaling wat menslike pariteitsinnovasies in die wolk moontlik maak
In Maart 2018 het ons Aangekondig (Hassan et al. 2018) 'n deurbraakresultaat waar ons vir die eerste keer 'n Masjienvertalingstelsel gewys het wat sowel as menslike vertalers kon presteer (in 'n spesifieke scenario – Chinees-Engelse nuusvertaling). Dit was 'n opwindende deurbraak in masjienvertalingnavorsing, maar die stelsel wat ons vir hierdie projek gebou het, was 'n komplekse, swaargewignavorsingstelsel wat verskeie voorpunttegnieke insluit. Terwyl ons die uitvoer van hierdie stelsel op verskeie toetsstelle vrygestel het, was die stelsel self nie geskik vir implementering in 'n intydse masjienvertalingwolk-API nie.
Vandag is ons opgewonde om die beskikbaarheid in die produksie van ons nuutste generasie neurale Masjienvertalingsmodelle aan te kondig. Hierdie modelle inkorporeer die meeste van die goedheid van ons navorsingstelsel en is nou by verstek beskikbaar wanneer jy die Microsoft Translator API gebruik. Hierdie nuwe modelle is vandag beskikbaar in Chinees, Duits, Frans, Hindi, Italiaans, Spaans, Japannees, Koreaans en Russies, van en na Engels. Meer tale kom binnekort.
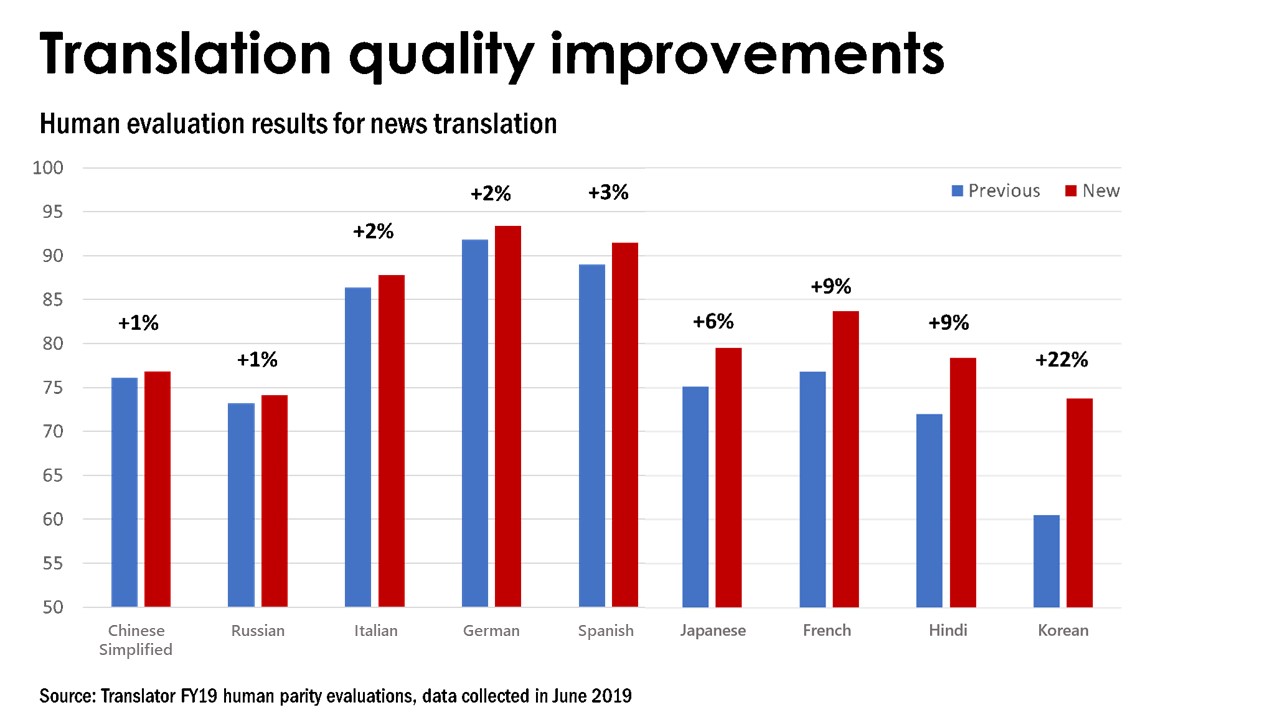
Gaan van navorsingsvraestel na Cloud API
Die afgelope jaar het ons gesoek na maniere om baie van die kwaliteit van ons menslike pariteitstelsel in die Microsoft te bring Vertaler API, terwyl u voortgaan om goedkoop intydse vertaling aan te bied. Hier is 'n paar van die stappe op daardie reis.
Opleiding vir onderwyser-student
Ons eerste stap was om oor te skakel na 'n "onderwyser-student" raamwerk, waar ons 'n liggewig intydse student oplei om 'n swaargewig-onderwysersnetwerk na te boots (Ba en Caruana 2014). Dit word bewerkstellig deur die student nie op te lei op die parallelle data waarop MV-stelsels gewoonlik opgelei word nie, maar op vertalings wat deur die onderwyser geproduseer word (Kim en Rush 2016). Dit is 'n eenvoudiger taak as om uit rou data te leer, en stel 'n vlakker, eenvoudiger student in staat om die komplekse onderwyser baie noukeurig te volg. Soos 'n mens sou verwag, het ons aanvanklike pogings steeds kwaliteitsdalings van onderwyser tot student gely (geen gratis middagete nie!), Maar ons het nietemin die eerste plek behaal in die WNMT 2018 Shared Task on Efficient Decoding (Junczys-Dowmunt et al. 2018a). 'N Paar besonder opwindende resultate van hierdie poging was dat Transformer (Vaswani et al. 2017) modelle en hul wysigings speel goed met onderwyser-student-opleiding en is verstommend doeltreffend tydens afleiding op die SVE.
Leer uit hierdie aanvanklike resultate en na baie iterasie ontdek ons 'n resep waarmee ons eenvoudige student byna dieselfde kwaliteit as die komplekse onderwyser kan hê (soms is daar tog 'n gratis middagete?). Nou was ons vry om groot, komplekse onderwysermodelle te bou om kwaliteit te maksimeer, sonder om bekommerd te wees oor intydse beperkings (te veel).
Intydse vertaling
Ons besluit om oor te skakel na 'n onderwyser-student raamwerk is gemotiveer deur die groot werk deur Kim en Rush (2016) vir eenvoudige RNN-gebaseerde modelle. Op daardie stadium was dit onduidelik of die gerapporteerde voordele ook vir Transformer-modelle sou manifesteer (sien Vaswani et al. 2017 vir besonderhede oor hierdie model). Ons het egter vinnig ontdek dat dit inderdaad die geval was.
Die Transformer-student kan 'n baie vereenvoudigde dekoderingsalgoritme (gulsige soektog) gebruik waar ons net die beste vertaalde woord by elke stap kies, eerder as die gewone metode (balksoektog) wat behels dat ons deur die groot ruimte van moontlike vertalings soek. Hierdie verandering het minimale kwaliteitsimpak gehad, maar het tot groot verbeterings in vertaalspoed gelei. Daarteenoor sal 'n onderwysermodel 'n beduidende daling in kwaliteit ly wanneer daar van balksoektog na gulsige soektog oorgeskakel word.
Terselfdertyd het ons besef dat die student eerder as om die nuutste neurale argitektuur (Transformer met self-aandag) in die dekodeerder te gebruik, aangepas kan word om 'n drasties vereenvoudigde en vinniger herhalende (RNN) argitektuur te gebruik. Dit is belangrik, want hoewel die Transformer-kodeerder parallel oor die hele bronsin bereken kan word, word die teikensin 'n enkele woord op 'n slag gegenereer, dus het die snelheid van die dekodeerder 'n groot impak op die algehele spoed van vertaling. In vergelyking met self-aandag verminder die herhalende dekodeerder algoritmiese kompleksiteit van kwadraties tot lineêr in teikensinlengte. Veral in die onderwyser-student-omgewing het ons geen verlies aan kwaliteit gesien as gevolg van hierdie wysigings nie, nie vir outomatiese of menslike evalueringsresultate nie. Verskeie bykomende verbeterings soos parameterdeling het gelei tot verdere vermindering in kompleksiteit en verhoogde spoed.
Nog 'n voordeel van die onderwyser-student-raamwerk wat ons baie opgewonde was om te sien, is dat kwaliteitverbeterings oor tyd van die steeds groeiende en veranderende onderwysers maklik oorgedra word na 'n nie-veranderende studente-argitektuur. In gevalle waar ons probleme in hierdie verband gesien het, sou geringe toenames in studentemodelkapasiteit die gaping weer toemaak.
Dubbele leer
Die belangrikste insig agter dubbele leer (Hy et al. 2016) is die "retoervertaling"-tjek wat mense soms gebruik om vertaalkwaliteit na te gaan. Gestel ons gebruik 'n aanlynvertaler om van Engels na Italiaans te gaan. As ons nie Italiaans lees nie, hoe weet ons of dit 'n goeie werk gedoen het? Voordat u klik Stuur op 'n e-pos kan ons kies om die kwaliteit na te gaan deur die Italiaans terug te vertaal na Engels (miskien op 'n ander webwerf). As die Engels wat ons terugkry te ver van die oorspronklike afgedwaal het, is die kans goed dat een van die vertalings van die spoor af gegaan het.
Dubbele leer gebruik dieselfde benadering om twee stelsels (byvoorbeeld Engels->Italiaans en Italiaans->Engels) parallel op te lei, deur die retoervertaling van een stelsel te gebruik om die ander stelsel te score, te valideer en op te lei.
Dubbele leer was 'n groot bydraer tot ons navorsingsresultaat oor menslike pariteit. Deur van die navorsingstelsel na ons produksieresep te gaan, het ons hierdie benadering breedweg veralgemeen. Nie net het ons pare stelsels op mekaar se uitset opgelei nie, ons het ook dieselfde maatstaf gebruik om ons parallelle data te filter.
Skoonmaak van onakkurate data
Masjienvertalingstelsels word opgelei op "parallelle data", d.w.s. pare dokumente wat vertalings van mekaar is, ideaal geskep deur 'n menslike vertaler. Soos dit blyk, is hierdie parallelle gegewens dikwels vol onakkurate vertalings. Soms is die dokumente nie werklik parallel nie, maar slegs los parafrases van mekaar. Menslike vertalers kan kies om bronmateriaal uit te laat of bykomende inligting in te voeg. Die data kan tikfoute, spelfoute, grammatikale foute bevat. Soms word ons data-ontginningsalgoritmes mislei deur soortgelyke maar nie-parallelle data, of selfs deur sinne in die verkeerde taal. Die ergste van alles is dat baie van die webblaaie wat ons sien strooipos is, of in werklikheid masjienvertalings eerder as menslike vertalings kan wees. Neurale stelsels is baie sensitief vir hierdie soort onakkuraatheid in die data. Ons het gevind dat die bou van neurale modelle om outomaties hierdie onakkuraathede te identifiseer en ontslae te raak, sterk verbeterings in die kwaliteit van ons stelsels gegee het. Ons benadering tot datafiltrering het gelei tot die eerste plek in die WMT18 parallelle korpus filter maatstaf (Junczys-Dowmunt 2018a) en het gehelp om een van die sterkste Engels-Duitse vertaalstelsels in die WMT18 Nuus vertaaltaak (Junczys-Dowmunt 2018b). Ons het verbeterde weergawes van hierdie benadering gebruik in die produksiestelsels wat ons vandag vrygestel het.
Ingerekende woordvoorstellings
Wanneer 'n navorsingstegnologie na produksie verskuif word, ontstaan verskeie werklike uitdagings. Om getalle, datums, tye, hoofletters, spasiëring, ensovoorts reg te kry, maak baie meer saak in produksie as in 'n navorsingstelsel.
Oorweeg die uitdaging van kapitalisasie. As ons die sin "KYK KATVIDEO'S HIER" vertaal. Ons weet hoe om "kat" te vertaal. Ons sal "CAT" op dieselfde manier wil vertaal. Maar oorweeg nou "Kyk na Amerikaanse sokker hier". Ons wil nie die woord "ons" en die akroniem "US" in hierdie konteks verwar nie.
Om dit te hanteer, het ons 'n benadering gebruik wat bekend staan as faktoriseerde masjienvertaling (Koehn en Hoang 2007, Sennrich en Haddow 2016) wat soos volg werk. In plaas van 'n enkele numeriese voorstelling ("inbedding") vir "kat" of "CAT", gebruik ons verskeie inbeddings, bekend as "faktore". In hierdie geval sou die primêre inbedding dieselfde wees vir "CAT" en "kat", maar 'n aparte faktor sou die hoofletters verteenwoordig, wat toon dat dit in die een geval all-caps was, maar kleinletters in die ander. Soortgelyke faktore word aan die bron en die teikenkant gebruik.
Ons gebruik soortgelyke faktore om woordfragmente en spasiëring tussen woorde te hanteer ('n komplekse kwessie in nie-spasiëring of semi-spasiëring tale soos Chinees, Koreaans, Japannees of Thai).
Faktore het ook die vertaling van getalle dramaties verbeter, wat in baie scenario's van kritieke belang is. Getalvertaling is meestal 'n algoritmiese transformasie. Byvoorbeeld, 1,234,000 kan geskryf word as 12,34,000 in Hindi, 1.234.000 in Duits en 123.4万 in Chinees. Tradisioneel word getalle soos woorde voorgestel, as groepe karakters van verskillende lengtes. Dit maak dit moeilik vir masjienleer om die algoritme te ontdek. In plaas daarvan voer ons elke syfer van 'n getal afsonderlik, met faktore wat begin en einde aandui. Hierdie eenvoudige truuk het byna alle nommervertalingsfoute robuust en betroubaar verwyder.
Vinniger model opleiding
Wanneer ons 'n enkele stelsel na 'n enkele doel oplei, soos ons vir die menslikepariteitsnavorsingsprojek gedoen het, verwag ons om 'n groot aantal hardeware na modelle te gooi wat weke neem om op te lei. Wanneer produksiemodelle vir 20+ taalpare opgelei word, word hierdie benadering onhoudbaar. Ons het nie net redelike omdraaitye nodig nie, maar ons moet ook ons hardeware-eise modereer. Vir hierdie projek het ons 'n aantal prestasieverbeterings aangebring aan Marian NMT (Junczys-Dowmunt et al. 2018b).
Marian NMT is die open source Neural MT-gereedskapstel waarop Microsoft Translator gebaseer is. Marian is 'n suiwer C ++ neurale masjienvertalingsgereedskapstel, en gevolglik uiters doeltreffend, wat nie GPU's tydens looptyd benodig nie, en baie doeltreffend tydens oefentyd
As gevolg van sy selfstandige aard, is dit redelik maklik om Marian te optimaliseer vir NMT-spesifieke take, wat lei tot een van die doeltreffendste NMT-gereedskapstelle wat beskikbaar is. Kyk na die maatstawwe. As jy belangstel in Neurale MV-navorsing en -ontwikkeling, sluit asseblief aan en dra by tot die gemeenskap op Github.
Ons verbeterings rakende opleiding en dekodering met gemengde presisie, sowel as vir groot modelopleiding, sal binnekort in die openbare Github-bewaarplek beskikbaar gestel word.
Ons is opgewonde oor die toekoms van neurale masjienvertaling. Ons sal voortgaan om die nuwe modelargitektuur na die oorblywende tale uit te voer en Pasgemaakte vertaler dwarsdeur hierdie jaar. Ons gebruikers sal outomaties die aansienlik beter gehalte vertalings kry deur die Vertaler APIOns Vertaler-toepassing, Microsoft Office en die Edge-blaaier. Ons hoop die nuwe verbeterings help jou persoonlike en professionele lewens en sien uit na jou terugvoer.
Verwysings
- Jimmy Ba en Ryk Caruana. 2014. Moet diep nette regtig diep wees? Vooruitgang in neurale inligtingverwerkingstelsels 27. Bladsye 2654-2662. https://papers.nips.cc/paper/5484-do-deep-nets-really-need-to-be-deep
- Hany Hassan, Anthony Aue, Chang Chen, Vishal Chowdhary, Jonathan Clark, Christian Federmann, Xuedong Huang, Marcin Junczys-Dowmunt, William Lewis, Mu Li, Shujie Liu, Tie-Yan Liu, Renqian Luo, Arul Menezes, Tao Qin, Frank Seide, Xu Tan, Fei Tian, Lijun Wu, Shuangzhi Wu, Yingce Xia, Dongdong Zhang, Zhirui Zhang, Ming Zhou. 2018. Die bereiking van menslike pariteit op outomatiese Chinese tot Engelse nuusvertaling. http://arxiv.org/abs/1803.05567
- Hy, Di en Xia, Yingce en Qin, Tao en Wang, Liwei en Yu, Nenghai en Liu, Tie-Yan en Ma, Wei-Ying. 2016. Dubbele leer vir masjienvertaling. Vooruitgang in neurale inligtingverwerkingstelsels 29. Bladsye 820-828. https://papers.nips.cc/paper/6469-dual-learning-for-machine-translation
- Marcin Junczys-Dowmunt. 2018a. Dubbele voorwaardelike kruis-entropiefiltrering van raserige parallelle korpora. Verrigtinge van die Derde Konferensie oor Masjienvertaling: Gedeelde Taakreferate. België, bladsye 888-895. https://aclweb.org/anthology/papers/W/W18/W18-6478/
- Marcin Junczys-Dowmunt. 2018b. Microsoft se voorlegging aan die WMT2018 Nuusvertalingstaak: Hoe ek geleer het om op te hou om bekommerd te wees en lief te wees vir die data. Verrigtinge van die Derde Konferensie oor Masjienvertaling: Gedeelde Taakreferate. België, bladsye 425-430. https://www.aclweb.org/anthology/W18-6415/
- Marcin Junczys-Dowmunt, Kenneth Heafield, Hieu Hoang, Roman Grundkiewicz, Anthony Aue. 2018a. Marian: Koste-effektiewe neurale masjienvertaling van hoë gehalte in C ++. Verrigtinge van die 2de werkswinkel oor neurale masjienvertaling en -generasie. Melbourne, Australië, bladsye 129-135. https://aclweb.org/anthology/papers/W/W18/W18-2716/
- Marcin Junczys-Dowmunt, Roman Grundkiewicz, Tomasz Dwojak, Hieu Hoang, Kenneth Heafield, Tom Neckermann, Frank Seide, Ulrich Germann, Alham Fikri Aji, Nikolay Bogoychev, André F. T. Martins, Alexandra Birch. 2018b. Marian: Vinnige neurale masjienvertaling in C ++. Verrigtinge van ACL 2018, Stelseldemonstrasies. Melbourne, Australië, bladsye 116-121. https://www.aclweb.org/anthology/P18-4020/
- Yoon Kim en Alexander M. Rush. 2016. Kennisdistillasie op volgordevlak. In Verrigtinge van die 2016-konferensie oor empiriese metodes in natuurlike taalverwerking, EMNLP 2016, Austin, Texas, VSA, 1-4 November 2016, bladsye 1317–1327. https://aclweb.org/anthology/papers/D/D16/D16-1139/
- Philipp Koehn, Hieu Hoang. 2007. Berekende vertaalmodelle. Verrigtinge van die gesamentlike konferensie oor empiriese metodes in natuurlike taalverwerking en berekening van natuurlike taalleer in 2007 (EMNLP-CoNLL). Praag, Tsjeggië, bladsye 868-876. https://www.aclweb.org/anthology/D07-1091/
- Rico Sennrich, Barry Haddow. 2016. Linguistiese insetfunksies verbeter neurale masjienvertaling. Verrigtinge van die eerste konferensie oor masjienvertaling: Deel 1, navorsingsartikels. Berlyn, Duitsland, bladsye 83-91. https://www.aclweb.org/anthology/W16-2209/
- Vaswani, Ashish en Shazeer, Noam en Parmar, Niki en Uszkoreit, Jakob en Jones, Llion en Gomez, Aidan N en Kaiser, Lukasz en Polosukhin, Illia. 2017. Aandag is al wat jy nodig het. Vooruitgang in neurale inligtingverwerkingstelsels 30. Bladsye 5998-6008. https://papers.nips.cc/paper/7181-attention-is-all-you-need


